Ref
MIRIX: Multi-Agent Memory System for LLM-Based Agents
Although memory capabilities of AI agents are gaining increasing attention, existing solutions remain fundamentally limited. Most rely on flat, narrowly scoped memory components, constraining their ability to personalize, abstract, and reliably recall user
arxiv.org
MIRIX - Advanced Memory System for LLM Agents
Building Your Personal Assistant with the Most Advanced Memory System. 85.38% LOCOMO accuracy with 99.9% storage reduction.
mirix.io
들어가며
올해 상반기에 Agent Project들을 진행하며, Agent든 LLM이든 Memory가 중요하다는 것을 느끼게 되었다.
결국 Memory를 어떻게 잘 관리하고 Memory에서 정보를 얼마나 잘 갖고오냐가 사용자 체감 성능에도 큰 영향을 미친다는 것을 느꼈기 때문이다.
이러한 연유로 Agent Memory에 관한 다양한 논문들을 찾아보게 되었고, 그 중 가장 최신 SOTA 논문인 MIRIX를 읽게 되었다.
해당 논문의 가장 핵심 아이디어는 1개의 Memory System이 아닌 6개로 Memory를 구분하여 저장하는 형태라는 점이고, 뭔가 기술적으로 절대 생각하지 못할 아이디어를 연구한 것은 아님에도 좋은 성능을 냈다는게 놀라운 점 중 하나인 것 같다.
사람이라면 누구나 Memory를 어떻게 관리할까를 고민하게 되고, 나 또한 Memory를 여러 개로 나누어 관리하게 되면 더 좋은 성능을 낼 수 있지 않을까 생각은 해봤었기 때문에 신선했다.
이 논문은 읽기에 어려운 논문은 아니었으나, 논문에서 구현할 때 기존의 Mem0, MemGPT와 같은 기존 논문을 참고하여 제작하였기에 이후에는 Related Work까지 읽어야 이 논문을 완벽하게 이해했다고 할 수 있을 것 같다.
Abstract
논문의 Abstract에서는 일반적인 논문과 같이 배경, 문제, 해결법, 기대효과를 말하고 있다.
각 내용은 다음과 같다.
배경(문제)
- AI Agent의 Memory capabilities는 점점 관심을 얻고 있지만, 기존의 solution들은 여전히 fundamentally limited.
- 대부분의 existing solution은 flat, narrowly scoped 메모리 compnent에 의존한다.
- 이로 인해 personalize, abstract, reliably recall user-specific information 능력이 시간이 지남에 따라 제한된다.
해결법
- 이를 위해, MIRIX라는 modular, multi-agent memory system을 제안한다.
- language model이 진짜로 기억하게하는 critical challenge를 해결함으로써 미래의 AI Memory를 재정의하는 것이 MIRIX
- MIRIX는 기존의 접근들과 다르게, text 뿐만 아니라 rich visual and multimodal experiences를 수용하여 memory가 real-world scenarios에서 genuinely useful하게 한다.
- MIRIX는 아래의 6가지 structured memory type으로 이루어지고, 이를 update 및 retrieval을 조정하고 dynamically control하는 multi-agent framework와 결합한다.
- Core
- Episodic
- Semantic
- Procedural
- Resource Memory
- Knowledge Vault
기대효과
- MIRIX는 Agent를 큰 규모에서도 다양한 long-term user data를 지속하고, 추론하고, 정확하게 retrieve하게 한다.
이 외에도 Abstact에서 실험 방식에 대한 간단한 소개, 성능 자랑, MIRIX를 사용할 수 있는 package application 공유 등을 이야기 한다.
1. Introduction
Introduction에서는 다음과 같은 이야기를 진행한다.
- 다시 한 번 현재 상황 및 문제 제기
- 기존 연구 소개 및 한계
- 본 논문 연구 소개
- 본 논문 실험 방식 소개
- 본 논문 기여 요약
현재 상황 및 문제 제기
- LLM Agent의 최근 발전은 능력 향상에 초점이 맞춰져있다.
- EX, code debugging, web browsing을 자동화하기 위한 repository management 등
- 위와 같은 기능도 중요하지만, memory는 foundational한데 아직 underexplore되었다.
- Memory는 past user-specific information을 활용하고, 지속하고, retrieve하기 위한 능력
- Human cognition은 memory에 많이 의지한다. (과거 대화를 recall하고, 패턴을 인식하는 등)
- 동시에 LLM Agent의 memory mechanism 또한, consistent 전달, 개인화된 interaction, feedback으로부터 학습, 반복된 query 피하기 등에서 필수적이다.
- 하지만! 여기서 문제가 있다.
- 현재 대부분의 LLM based personal assistant들은 현재 prompt window를 넘어서면 stateless 상태고, context가 explicitly re-provided되지 않는 한 지속적인 메모리를 유지하지 않는다.
- 이러한 문제는 사용자가 시간이 지남에 따라 assistant가 더욱 개인화되길 기대하는 real-world setting에서 특히 long-term usability를 저해하게 한다.
기존 연구 소개 및 한계
- 이러한 문제를 해결하기 위해 memory augmented system들이 많이 제안되었다.
- 1. knowledge graph 사용
- 2. flattened memory architecture
- Letta(Memgpt), Mem0, ChatGPT memory system
- 이 방식은 vector database를 이용하여 textual chunk를 store/retrieve하는 방식이다.
- Letta의 경우 memory를 components(대화 기록용 메모리, 선호도 메모리, long document 메모리)로 나누는 방식이다. (여기서도 IDEA를 얻은 듯하다.)
- ChatGPT의 경우, core and recall memory들에만 집중한다.
- Mem0의 특징은 아래와 같다.
- user input을 distill하여 flattened fact로 저장한다.
- Letta의 archival memory(long document memory)와 유사한 역할을 한다.
- 하지만, Letta보다 more distiil되어 더 압축적이고, 정제된 형태로 저장한다.
- 이렇게 많은 시스템이 존재하지만, 이러한 기존 memory system은 아래와 같은 문제를 직면한다.
- compositional memory structure 부족
- 대부분의 접근은 single flat store에서 모든 historical data를 저장한다. (specialized memory type 구분 X)
- 이로인해, retrieval은 비효율적이고 덜 정확하게 된다.
- Poor multi-modal support
- 기존 시스템은 Text-centric memory mechanism으로 대부분의 input이 언어가 아닐 때(image, map 등) 실패한다.
- Scalability and abstraction
- salient information만 저장하고 요약하기 위한 effective abstraction layer가 없기에 memory requirement가 매우 많아진다.
- 특히 image
- salient information만 저장하고 요약하기 위한 effective abstraction layer가 없기에 memory requirement가 매우 많아진다.
- compositional memory structure 부족
본 논문 연구 소개
지금까지 기존 memory system의 한계들을 보았다. 이 논문에서는 이러한 기존 한계들을 해결하기 위한 방법론을 제시한다.
그 전에 먼저 연구자들은 이러한 문제를 해결하기 위해서는 Routing과 Retrieving이 memory-augmented agent가 반드시 가져야 할 key capabilities라고 한다.
그 이유는 현재 system들은 대부분 Short-Term, Long-Term Memory에만 focus하기 때문이다. (몇몇은 Mid-Term까지)
연구자들은 이것이 아닌 specialized memory types를 탐색한 연구로부터 영감을 받았다고 한다.
- 그리고 이것으로부터 아래와 같은 6개의 memory components로 구성된 comprehensive architecture MINIX를 제안한다.
- Core Memory
- Episodic Memory : user-specific events and experiences 저장
- Semantic Memory : concepts and named entities 저장
- Precedural Memory : task 수행을 위한 step by step instructions 저장
- Resource Memory : documents, files, user에 의해 공유되는 other media 저장
- Knowledge Vault : 정확하게 보존되어야 하는 critical verbatim information(주소, 폰 번호 등) 저장
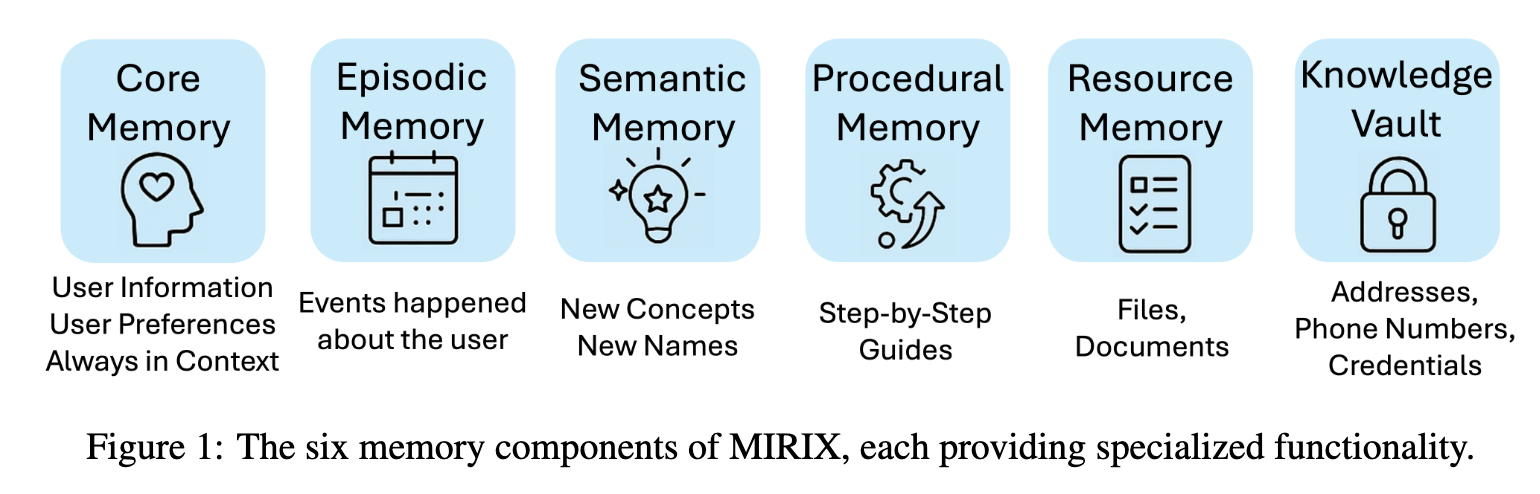
- 그리고 각 memory component들은 내부적으로 hierarchical structure로 organize되어있다.
- For Example
- Episodic Memory : summary and details field 포함
- Semantic Memory : name and description 포함
- For Example
- 이러한 structured and heterogeneous memory를 다루는 것은 single agent로는 어렵기에 본 논문에서는 multi-agent architecture를 적용한다.
- multi-agent architecture
- 6개의 memory component에 대해 6개의 Memory Managers가 존재함.
- Meta Memory Manager가 task routing을 책임짐
- multi-agent architecture
- 또한, 이 memory system은 기존의 agent에 연결될 수 있는 형태로 제작 되었고 이를 보여주기 위해 Chat Agent도 제작함.
- 이러한 종합적인 memory system을 MIRIX라고 부르고, 이는 아래와 같은 특징을 가진다.
- modular : module처럼 이용 가능
- comprehensive and LLM-based agent를 위한 full memory system으로 design : 단편적인 메모리 기능이 아니라 완전한 full memory 제공
- 추가적으로 Chat Agent와 상호작용할 때, Active Retrieval mechanism을 제안한다.
- Active Retrieval mechanism
- Agent가 다음 step을 실행하거나 question에 답변하기 전에 topic을 생성해야 하는 mechanism
- 그리고 이렇게 retrieve된 information은 system prompt안에서 model에 input된다.
- Active Retrieval mechanism
- 또한, multiple retrieval tool을 design하여 agent가 다른 상황에 따라 적절한 도구를 선택할 수 있도록 한다.
본 논문 실험 방식 소개
이 내용은 Experiment 내용과 거의 동일해서 정말 짧게 작성하고 아래에서 자세히 다루겠다.
- MIRIX는 2가지 실험 환경에서 평가함.
- 직접 제작한 multimodal 환경 dataset
- LOCOMO dataset
- 이러한 실험에서 MIRIX의 성능
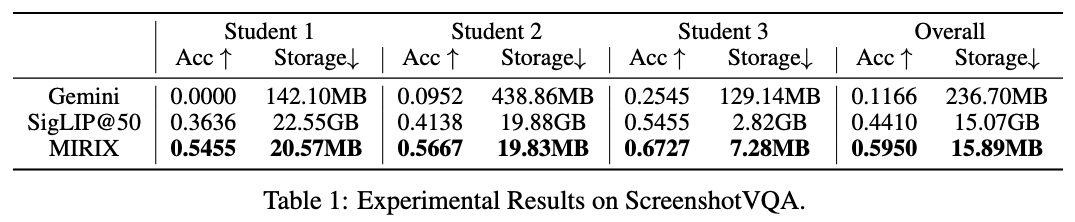
- RAG baseline보다 35% improvement, 93.3% storage 절약
- LOCOMO에서 MIRIX는 SOTA 달성 (85.38% 정확도)
본 논문의 기여
- 기존 memory architecutre의 한계를 분석하고, novel memory system(6개의 specialized components, eight different agents로 구성된)을 제안
- new benchmark 소개 : agent가 user behavior에 대한 이해를 구축하기 위해 large collection of screenshots을 해석해야하는 벤치마크 (memory challenge)
- new benchmark와 LOCOMO benchmark를 통해 MIRIX가 outperform하는 것을 보임
- MIRIX를 통해 이 시스템을 이용할 수 있도록 공개함.
2. Application & Use Cases
2.1. Mirix Application
- 논문의 memory system의 모든 기능을 보여주기 위해 cross-platform application을 제작함
- Frontend : React-Electron
- Backedn : Uvicorn
- 뿐만 아니라, 설치해서 사용할 수 있도록 direct installation 파일을 release
GitHub - Mirix-AI/MIRIX: Mirix is a multi-agent personal assistant designed to track on-screen activities and answer user questi
Mirix is a multi-agent personal assistant designed to track on-screen activities and answer user questions intelligently. By capturing real-time visual data and consolidating it into structured mem...
github.com
- 이 Application에서 user는 screen monitoring을 활성화할 수 있다. 이를 통해 agent는 user's screen activity를 관찰하고, memory를 dynamically update할 수 있다.
- 이렇게 획득한 memory를 이용하여 user의 question에 agent가 응답할 수 있다.
Memory Updates
- Application은 1.5초 간격으로 screenshot 촬영
- 이렇게 되면 중복이 생길 수 있다. 이를 감소하기 위해 visually similar한 사진은 discard된다.
- 촬영된 unique screenshot이 20개가 모이면, memory update process가 trigger되고, 이는 일반적으로 60초다.
- 이러한 process에서, 관련된 정보가 추출되고 system의 memory components에 통합된다.
- user의 screenshot을 처리하는 과정에서 latency가 발생할 수 있다. 이를 줄이기 위해 streaming upload strategy를 사용한다.
- 한 번에 20 image를 보내고 batching하는 대신에, front-end에서 수신하면 각 screenshot을 즉시 업로드 한다.
- 아마도, 이 즉시 업로드 직전에 검사를 하고 보낼 것 같다.
- Gemini API를 사용하여 효율적으로 accumulate하기 위한 full batch 기다림 없이 visual data를 전송할 수 있다.
- Gemini API는 Google Cloud URL을 통한 image loading을 지원함.
- 이를 통해 GPT-4와 다르게 비동기적 처리가 가능할 것으로 보임 (Cloud에 image upload를 하고 url만 전달하니까)
- Gemini API는 Google Cloud URL을 통한 image loading을 지원함.
- 이 방식은 end-to-end latency를 약 5초까지 줄인다.
- GPT-4를 사용하였을 땐, 50초 걸림
- 한 번에 20 image를 보내고 batching하는 대신에, front-end에서 수신하면 각 screenshot을 즉시 업로드 한다.
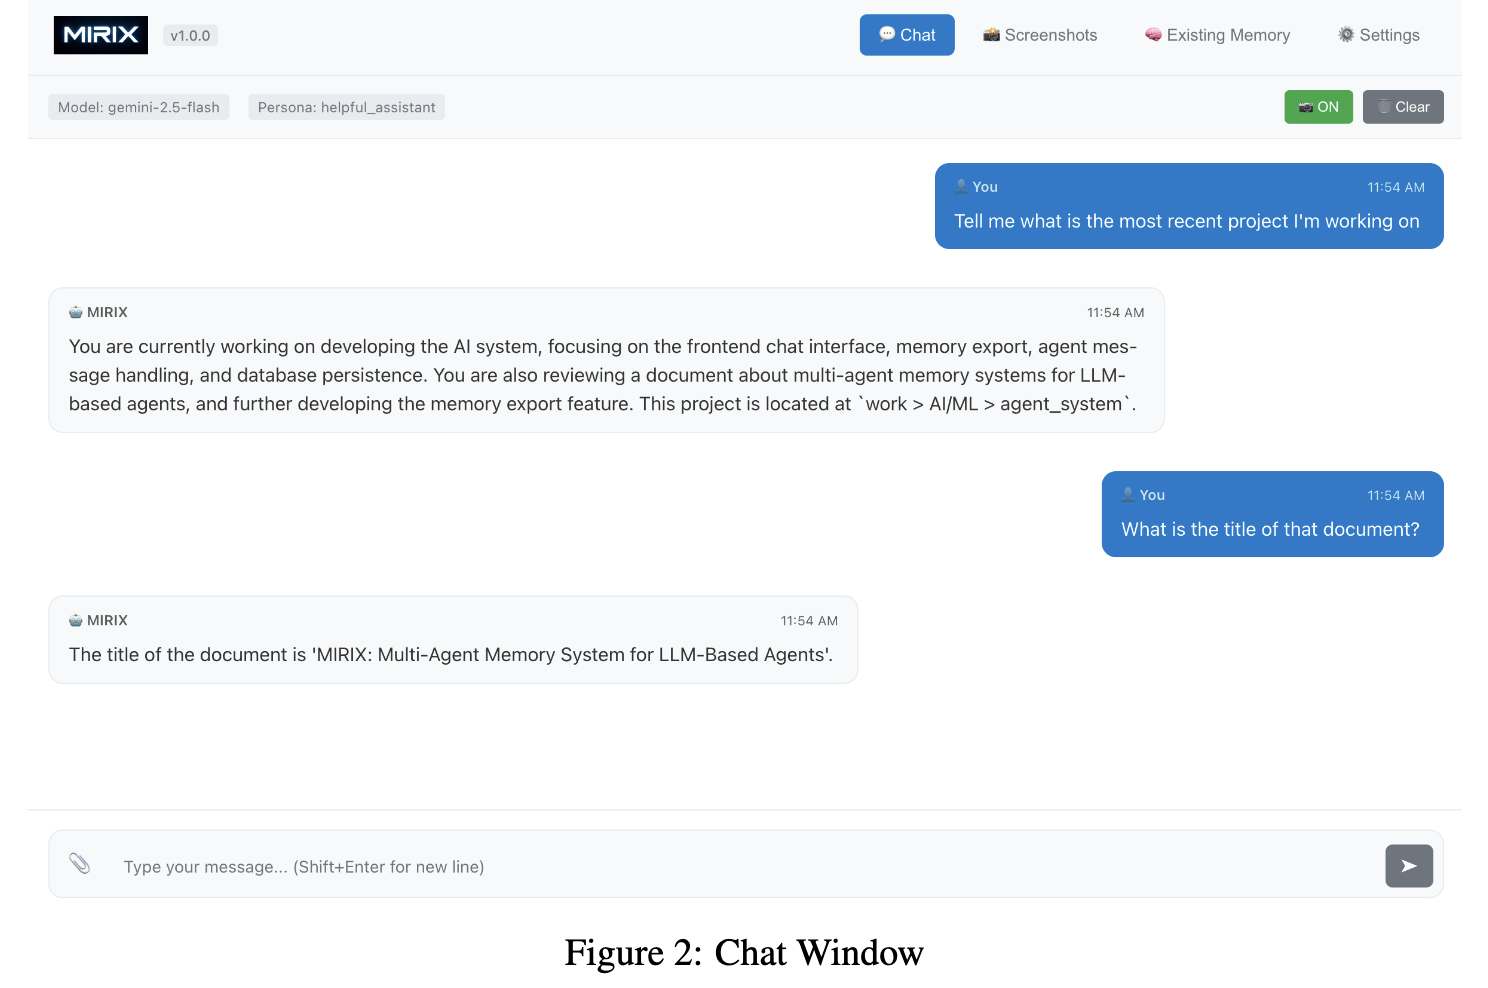
Chat Interface
크게 중요한 내용은 없어서 그냥 UI만 보면 될 것 같다.
Memory Visualization
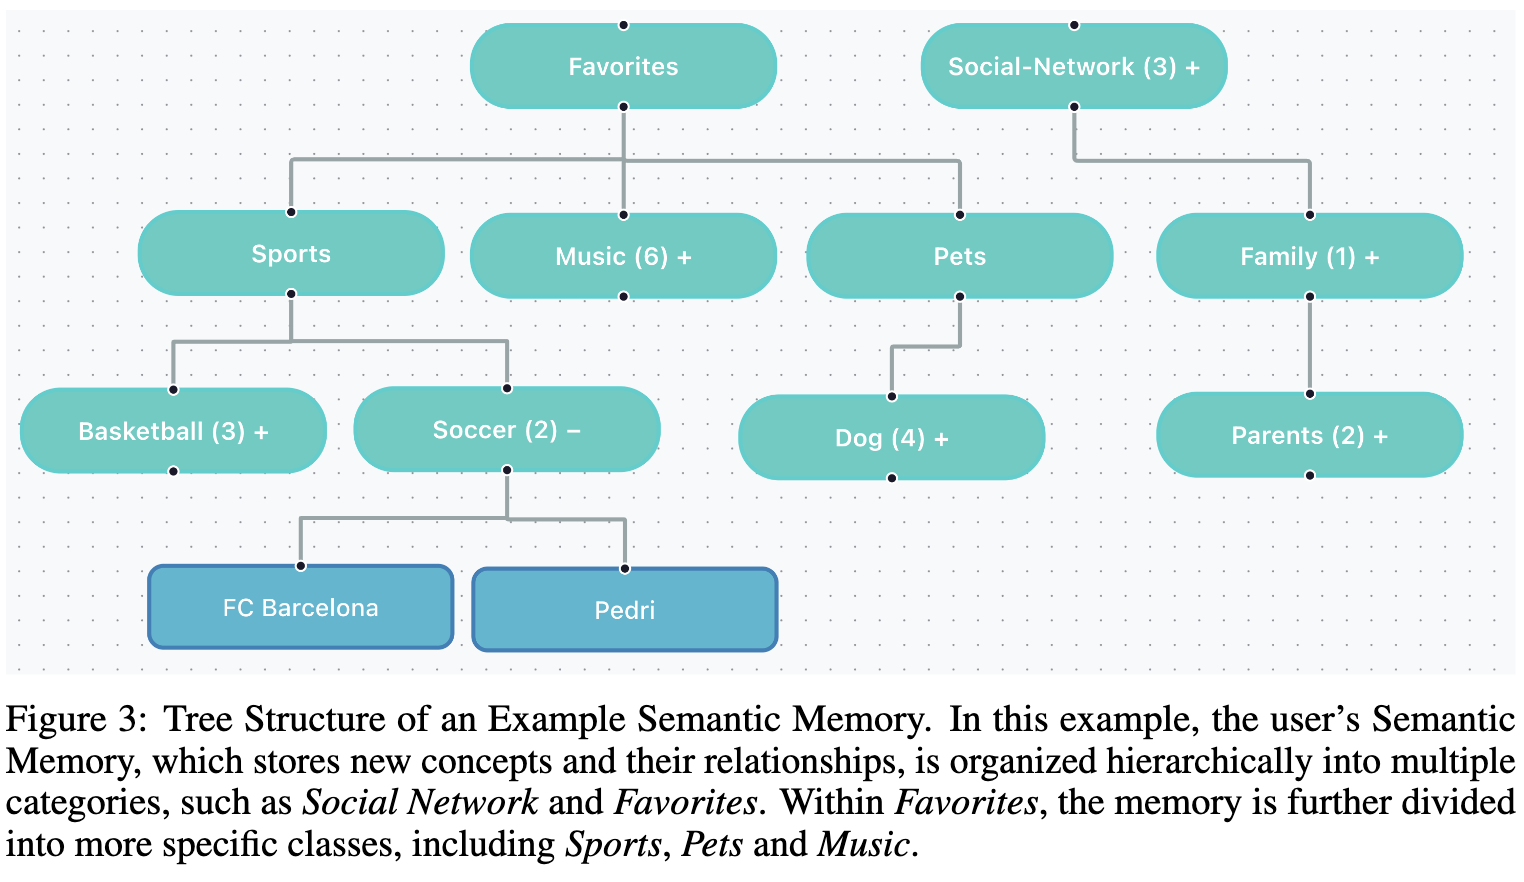
충분한 기간 동안 screen을 obseving한 후에, agent는 이 지식들을 structured memory components로 organize한다.
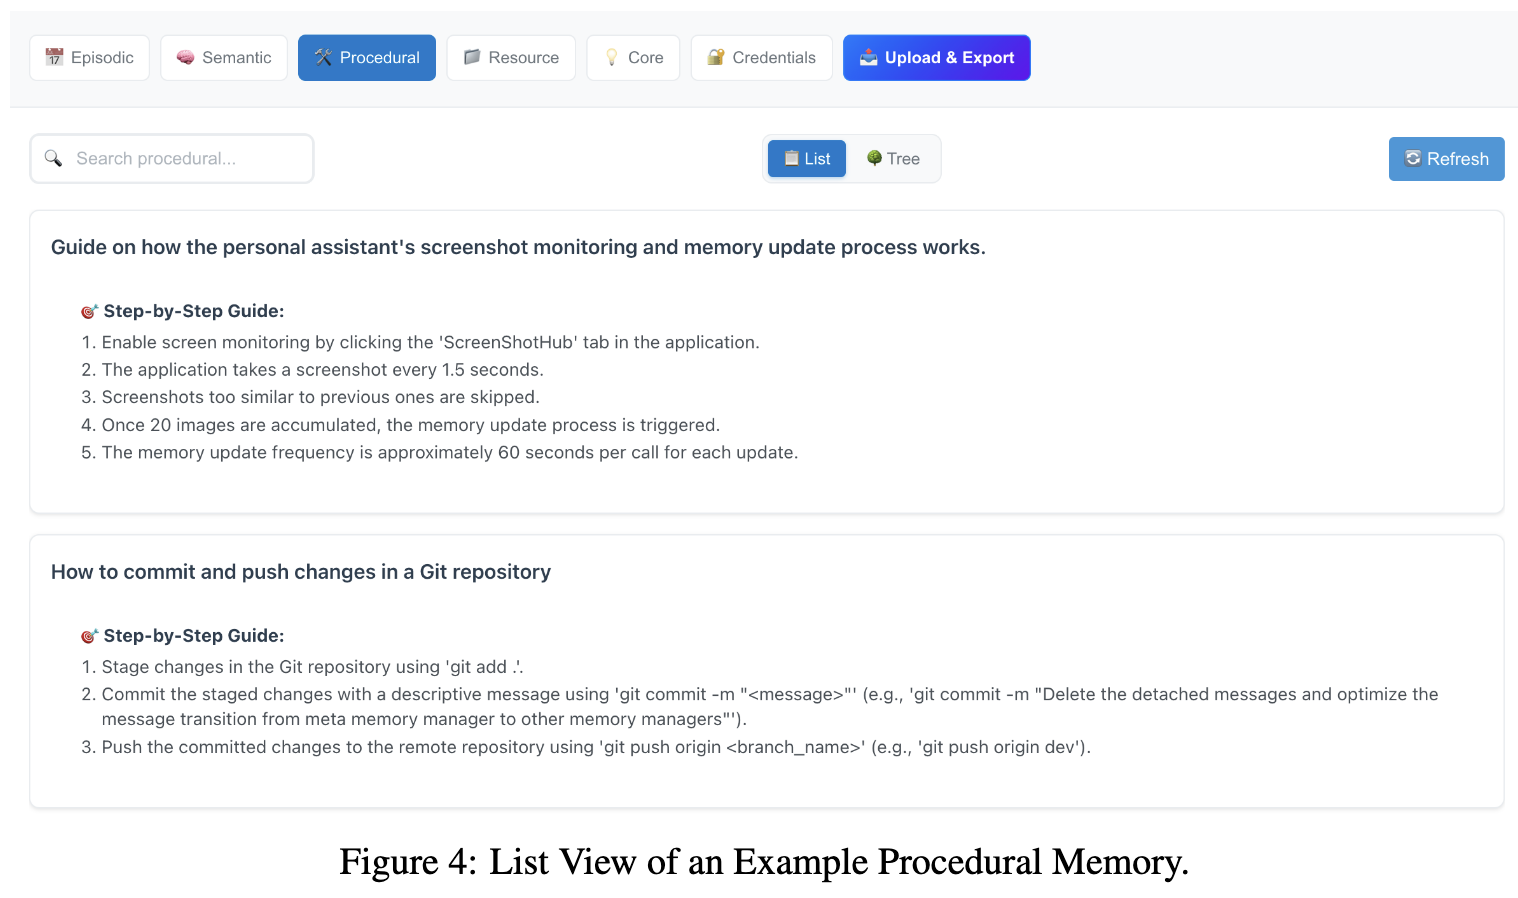
아래의 사진 2개가 각각 Semantic Memory의 예시(tree 형태), Procedural Memor의 예시(list view 형태)이다.
2.2 Memory System for Wearable Devices
- Wearable Devcie 시장은 몇 년새에 빠르게 성장하고 있다.
- AI-powered glasses, AI pins 등
- 이러한 Product들은 voice commands, visual capture, real-time feedback을 통해 daily life에 seamless interaction을 통합하는 것을 목표로 한다.
- 하지만, 문제!
- 이러한 device들은 long-term memory component가 부족하다는 문제를 가진다.
- 하지만, 논문의 Memory system은 wearable device에 통합하기에 좋다.
- 실시간으로 데이터를 처리할 수 있기 때문
- personalized evolved memory 때문
- modular architecture로 lightweight device에 적합
- procedural, episodic, semantic, resource memory
- 각 메모리는 다음과 같은 역할을 한다.
- Procedural memory : aasistant가 user habit(daily routes, meeting structures)을 학습하도록 함
- Semantic memory : general knowledge(user's preferences, evironments, routines 등)를 저장
- Episodic memory : time-stamped, situational experiences capture, recalling specific events query할 수 있음
- 예를 들어, 내가 저번주에 컨퍼런스에서 본건 뭐야? 이런식으로 query 가능
- Resource memory : 전체 도는 부분 document 등을 처리
- 주어진 wearable hardware의 제약에서, memory system은 hybrid management 또한 지원
- Knowledge Valut에서 Critical한 정보는 local 저장하는 등
- 요약하자면, 이 memory system은 wearable AI Agent를 위한 cognitive backbone 역할을 한다.
- wearable 시장이 성숙해짐에 따라, persistent, structured memory는 key differentiator가 될 것이다.
Agent Memory Marketplace
- Memory Marketplace에 대한 소개인데, 사실 본 논문과는 크게 상관없다. 그냥 이런 것도 했구나로 보면 될 것 같다.
- 본 연구자들은 personal memory가 new digital asset class가 되는 미래를 상상함.
- AI 시대에서, memory는 더이상 passive log가 아니라 active evolving knowledge base(공유되고, 개인화되고, 수익 창출되는)라고 생각하기 때문
- 그래서 Agent Memory Marketplace를 제안함.
- 이는 AI Agent를 통해 memory가 교환, 재사용, 구축 되는 decentralized ecosystem
- 그래서 이제 marketplace 에 대한 간단한 소개를 진행한다. marketplace는 3가지 key layer로 이루어져있다.
- AI Agents Infrastructure
- lifetime intelligent, interactive agents를 위한 infrastructure를 제공
- Example
- Personal AI Assistants&Companions : User에 맞춰 지속적으로 학습하고 진화하는 Tailored agents
- AI Wearables : decentralized physical infrasturcture에 embedded된 AI agent
- Multi-Agent Systems : shared memory access와 collaborate하는 agents
- Privacy-Preserving Memory Infrastructure
- trust와 adoption을 지원하기 위해 robust privacy layer를 구축
- Detail
- Encryption Layer : 모든 메모리는 end-to-end encryption을 사용하여 저장된다.
- Privacy Control : 세분화된 권한을 통해 user는 개인 메모리를 공유, 교환, 제한하도록 선택하게 할 수 있음
- Decentralized Storage : 메모리들은 decentralized, censorship-resistant infrastructure에 저장된다.
- Memory Marketplace and Social Function
- P2P 생태계
- Use Case
- Memory Social Traidng : Tokenized exchange of memories
- Expert Communities : 도메인 특화 전문들에 대한 collective memory-building
- Fan Economy and Dating Applications : User는 AI persona를 구독할 수 있음 (AI persona는 influencer, celebirity memory 기반)
- AI Agents Infrastructure
3. Methodology
3.1. Memory Components
앞서 말했듯, MIRIX의 Memory System은 6가지 구성요소로 이루어져있다. 본 단락에서는 각각에 대해 설명한다.
Core Memory
- high-priority, persistent 정보를 보관한다.
- Core Memory는 MemGPT로 부터 영감을 받아 제작하였다.
- Core Memory는 2가지 primary Block으로 이루어진다.
- persona : Agent의 identity, tone, behavior profile 등을 encode
- human : User의 name, preferences, self-identifying attributes 등의 enduring facts를 저장한다.
- Core Memory의 용량이 90%를 초과하게 되면, system이 controlled write process를 작동시켜 critical information의 손실 없이 compactness를 유지할 수 있도록 한다.
Episodic Memory
- time-stamped events, temporally grounded interactions를 capture한다.
- 이 정보는 user's behavior, experiences, activities 등이 존재한다.
- Episodic Memory는 Structured log 또는 calender역할을 하여, agent가 user의 routine, recency, context follow-ups에 대해 추론할 수 있게한다.
- Episodic Memory의 Entry는 다음과 같은 Field를 갖는다.
- event_type : user message, inferred result, system notification 등
- summary : event에 대한 간결한 natural language description
- detail : 확장된 contextual information (dialog 발췌(excerpt), inferred states 등을 포함)
- actor : event의 origin (user or assistant)
- timestamp : 우리가 아는 타임스탬프
- 이러한 구조의 Episodic Memory는 Agent에게 시간이 지남에 따라 일시적으로 memory에 index하고 추적할 수 있도록 한다.
- 간단하게 말해 발생한 사건을 indexing하여 찾을 수 있게 한단 뜻이다.
- 예를 들어, 현재 진행중인 task가 무엇인지 파악하는 것을 말한다.
Semantic Memory
- 특정 시간이나 이벤트와 무관한 abstract knowledge / factual information을 저장한다.
- Semantic Memory는 general concepts, entities, relationships에 대한 knowledge base역할을 한다.
- Semantic Memory의 Entry는 다음과 같은 Field를 갖는다.
- name : the concept / entity identifier
- summary : a concise definition / relationship statement
- details : expanded background / contextual explanation
- source : EX, user_provided / Wikipedia
- Episodic Memory와 다르게 conceptually overwritten이 이루어지지 않는 한 지속되도록 설계되었다.
- 개념적으로 덮어씌워지지 않는 한 변경되지 않는다는 의미
- 또한, social, geographic, commonsense knowledge 3가지 영역에서의 추론을 지원한다.
Procedural Memory
- structured, goal-directed process를 저장한다.
- how-to-guide, operational workflows, interactive scripts와 같은 것들을 저장한다는 것이다.
- 여기서 저장하는 정보는 time-sensitive(episoidc memory)이거나 abstract facts(semantic memory)는 아니지만, actionable knowledge을 나타낸다.
- actionable knowledge : complex task를 하는 user를 돕기 위해 invoke할 수 있는 지식
- EX, 어떻게 캐치테이블로 식당을 예약하는가
- actionable knowledge : complex task를 하는 user를 돕기 위해 invoke할 수 있는 지식
- Procedural Memory의 Entry는 다음과 같은 Field를 갖는다.
- entry_type : workflow, guide, script
- description : goal or function
- steps : instruction list를 표현 ( JSON / structured format )
- Procedural Memory는 다음을 지원한다.
- instrucional planning
- automation
- user goal을 sub-task list로 decomposition
Resource Memory
- Documents, transcripts, multi-modal files 등을 다룬다.
- 이러한 것들은 다른 메모리에 fit하지 않는 것들이다.
- EX, 내가 친구가 작성한 picnic plan을 읽는다던지, project 제안서를 읽는다던지 하면, 이 정보들은 에이전트가 Resource Memory에 저장하고 검색할 수 있다.
- Resource Memory는 long-running task에서 context continuity를 가능하게 한다.
- Resource Memory의 Entry는 다음과 같은 Field를 갖는다.
- title : resource name
- summary : brief overview and context
- resource_type : doc, markdown, pdf_text, image, voice_transcript
- content : full content / excerpted content
- 이러한 디자인으로 agent가 user's workflow를 돕기 위해 이전에 보았던 자료들을 참조할 수 있다.
Knowledge Vault
- 이 메모리는 API key나 address, credential같은 민감한 정보를 위한 secure repository 역할을 한다.
- Knowledge Vault의 Entry는 authenticated task를 수행하기 위하거나 long-term identifier를 저장하는데에 중요하다.
- 각 Entry가 포함하는 Field는 아래와 같다.
- entry_type : crediential, bookmark 등의 타입
- source : 어디서 가져왔는지 (user_provided, github 등)
- sensitivity_level : 얼마나 민감한지 (low, medium, high)
- secret_value : 실제 secret value
- 각 Entry가 포함하는 Field는 아래와 같다.
- 이러한 민감한 정보들은 misuse나 leakage를 예방해야 한다. 이는 access control과 casual retrieval을 통해 보호된다.
3.2. Active Retrieval and Retrieval Design
기존의 문제
- 많은 memory-augmented system에서 memory retrieval은 explicitly trigger된다.
- 내가 직접 "메모리를 참고해서 말해줘~" 해야 참고한다.
- 반면에, language model은 내재된 지식(parametric knowledge)를 default로 하고 이 지식은 당연하게도 outdated거나 incorrect다.
- 예를 들어보자, 내가 "삼성전자 CEO는 박용인사장이야."라고 하면 이 정보가 momry에 저장될 것이다. 하지만, 며칠 후 내가 "삼성전자 CEO가 누구야?" 라고 묻는다면 아마도 내재된 지식에 근거하여 틀린 답변을 할 것이다. 이러한 경우 내가 "너의 메모리에서 검색해줘"라고 한다면 어느정도 해결이 될 수 있지만, 이는 자연스러운 대화가 아니다.
- 위의가 논문에서 제시한 예신데, 별로 공감이 가지 않는다. 특히 GPT같은 언어 모델은 메모리에 저장되었으면 알아서 잘 대답했던 것 같은데 아무튼 이러한 예시를 주었다.
문제 해결
- 이러한 문제를 해결하기 위해 본 논문에서는 아래의 그림과 같은 Active Retrieval mechanism을 제안한다.
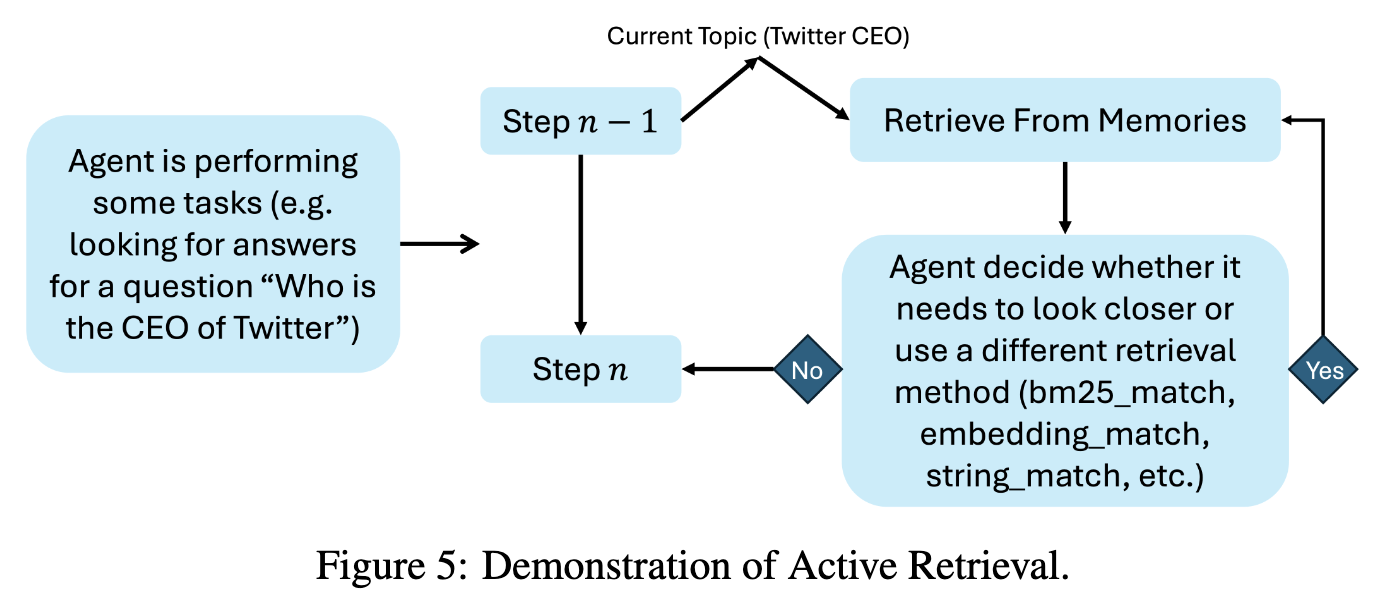
- 이 system은 위 그림에서 보이는 것처럼 2 stage로 동작한다.
- First Stage : Agent는 input context에 기반하여 current topic 을 생성함.
- Second Stage : First Stage에서 생성한 topic을 이용하여 각 memory component로부터 relevant memories를 검색한 후, 관련된 결과를 system prompt로 inject한다.
- 위의 그림에 예시가 잘 나와있으나 논문에서 그렇듯 한 번 더 설명을 작성하겠다.
- 만약 내가 "삼성전자 CEO가 누구야?"라고 묻는다면
- Agent는 First Stage에서 "삼성전자 CEO" 라는 current topic을 만들 것이다.
- 그리고 current topic 을 기반으로 6개의 memory component로부터 top-10 most relevant entries를 검색한다.
- 이렇게 retrieve된 결과는 <episodic_memory>...</episodic_memory> 이런식으로 source가 tagging 된다.
- 이러한 Automatic Retriever Pipeline은 user가 explicit하게 prompt를 작성할 필요를 없애고 model이 response generation동안 up-to-date(최신 정보), personalized(개인화된 정보), contextual information(맥락 정보)을 통합할 수 있게 보장한다.
- MIRIX는 Active Retriever외에도, embedding_math, bm25_match, string_match를 포함한 multiple retrieval function을 지원한다.
3.3. Multi-Agent Workflow
- user interaction은 dynamic & heterogeneous함. 이것을 다루기 위해 논문에서는 modular multi-agent architecture를 적용했다.
- 이 system은 coordinated and efficient workflow를 통해 6개의 distinct memory components에 걸쳐 input processing, memory updating, information retrieval를 orchestrate한다.
- 이게 무슨 말일까?
- 이는 MIRIX system의 전체적인 orchestration을 설명하는 것으로 보인다.
- 설명에 따르면 아마도 System orchestration에서는 workflow를 통해 input을 process하고, 처리된 input을 바탕으로 information retrieval을 진행하고, memory update를 진행할 것이다.
- 전체 시스템 구조 아래의 2가지 요소에 의해 관리된다.
- Central Meta Memory Manager
- 각각 하나의 Memory type을 담당하는 specialized Memory Managers의 집합
- 이게 무슨 말일까?
- 이 system은 coordinated and efficient workflow를 통해 6개의 distinct memory components에 걸쳐 input processing, memory updating, information retrieval를 orchestrate한다.
Memory Update Workflow
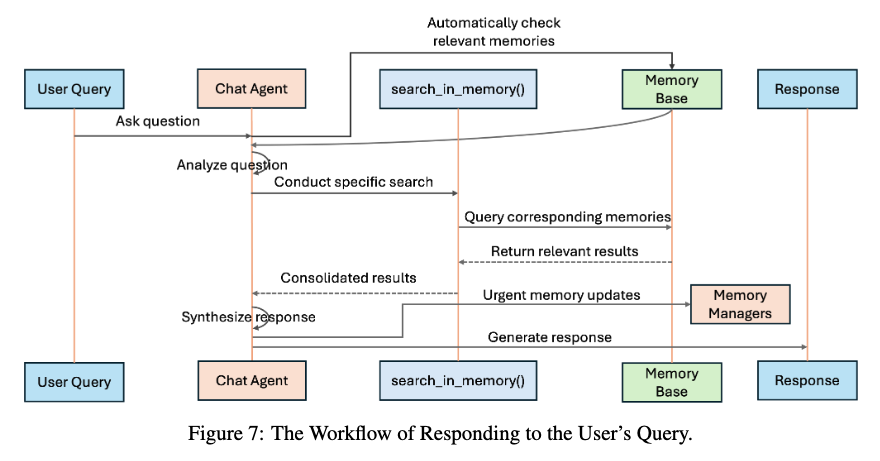
- Memory Update Workflow는 아래와 같다.
- 위 그림에서 보이는 것처럼, user로부터 new input을 받았을 때, system은 자동으로 search를 수행한다.
- retrieve된 정보는 user input과 함께 Meta Memory Manager로 전송된다.
- Meta Memory Manager는 content를 분석하고 관련된 memory components를 결정한 다음 input을 일치하는 Memory Manager로 routing한다.
- Memory Managers는 그들의 respective memories를 병렬적으로 update하고 동시에 각 memory type내에서 중복된 정보를 피하도록 보장한다.
- 위의 전 과정을 완료한 후, Meta Memory Manager에게 report한다.
Conversational Retrieval Workflow
- 대화형 Retrieval이 어떻게 흘러가는지도 살펴보겠다.
- 대화창에서 Chat Agent는 natural language communication을 관리한다.
- 사전 지식에 근거한 응답을 하기 위해 먼저 user query를 받아 automatic serach를 수행한다.
- 이 초기 검색은 모든 메모리에 대해 진행하는 coarse retrieval이고, high-level summaries를 return한다.
- 모든 메모리에 대해 간단하게 훑어보는 식으로 검색을 진행한다고 생각하면 된다.
- 이 초기 검색은 모든 메모리에 대해 진행하는 coarse retrieval이고, high-level summaries를 return한다.
- 이제 Chat Agent는 어떤 메모리 components가 더 targeted search를 보장하는지 결정하기 위해 query를 분석하고, 그에 따라 적절한 retrieval method를 선택한다.
- 어떤 memory의 정보가 더 맞는지 분석하고, 거기에서 어떻게 더 잘 가져올지 retrieval method를 선택한다고 생각하면 된다.
- relevant result를 얻은 후, 정보를 통합하고 final response를 synthesize한다.
- 최종 결과를 얻은 다음 정보들을 얻어 최종 응답을 생성한다고 생각하면 된다.
- 만약에 user's query가 updating memory를 포함하고 있다면?
- Chat Agent는 직접적으로 일치하는 Memory Manager와 interact하여 정확한 update를 적용할 수 있다.
4. Experiments
4.1. Experimental Setup
4.1.1. Datasets
ScreenshotVQA
- 저자들은 직접 VQA Dataset을 구성했다고 Introduction에서 얘기했다. 이에 대해 자세하게 설명한다.
- 연구자들은 3명의 PhD students' activities를 포함하는 new dataset을 수집한다.
- 이를 위해 매초 screenshot을 촬영하는 script를 만들었고, 3명의 박사과정 학생들은 이 script를 사용하여 1주~1달 정도 program을 실행하였다.
- 만약 여기서 image가 이전에 찍은 사진과 99% 이상 유사하면 해당 image는 skip한다.
- 이를 위해 매초 screenshot을 촬영하는 script를 만들었고, 3명의 박사과정 학생들은 이 script를 사용하여 1주~1달 정도 program을 실행하였다.
- 3명의 학생들의 각 특징을 정리하였는데 아래와 같다.
- heavy computer user : 하루에 5,886개의 image를 생성
- slightly light user : 20일동안 18,178 개의 이미지 생성 (일 평균 약 900개)
- lightest user : 1달동안 5349개의 이미지 생성
- 이러한 screenshot을 이용하여 각 학생들에게 몇 가지 질문을 만들어 달라고 요청하였고, 실제 답변 가능한 질문인지 double-check 했다고 한다.
- 최종적으로 연구자들은, 1번 사용자로부터 11개의 question, 2번 사용자로부터 21 question, 3번 사용자로부터 55 question을 얻었다.
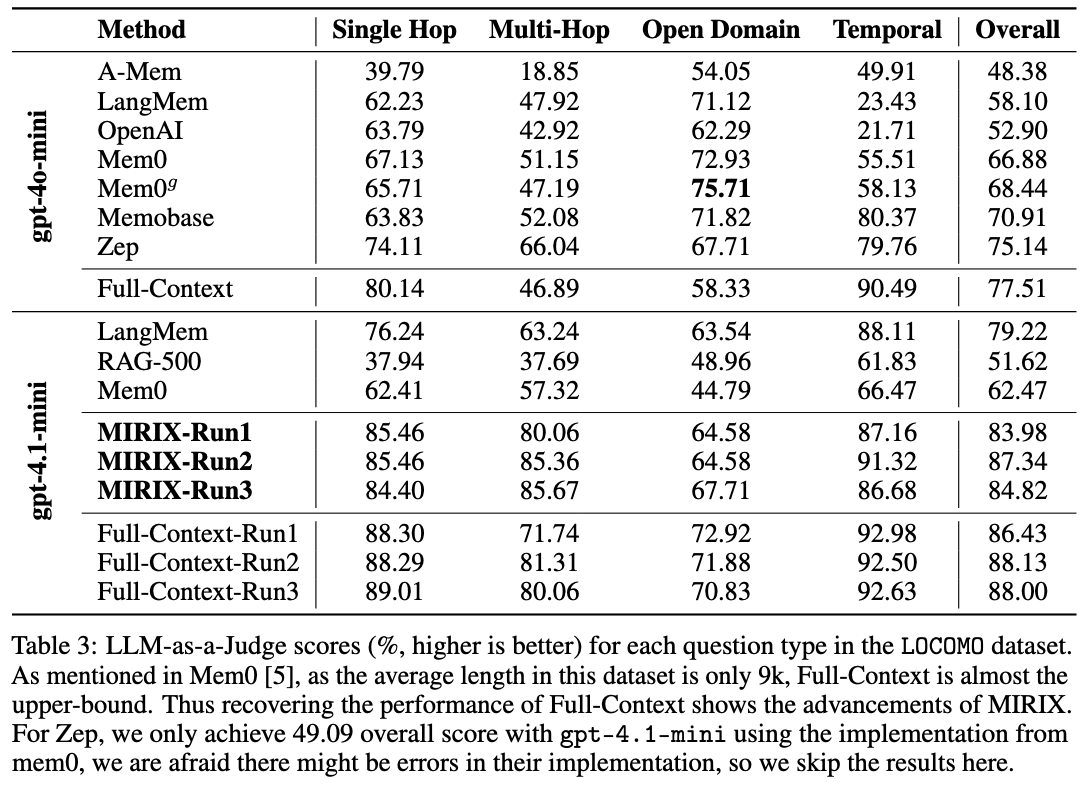
LOCOMO
- 직접 만든 데이터셋 외에도 LOCOMO라는 벤치마크를 사용한 평가도 진행했다고 한다. 이에 대해 설명한다.
- LOCOMO dataset은 아래와 같다.
- 10개의 conversations을 가짐
- 각 conversation은 600 dialogues와 26000 tokens, 200 questions 를 평균적으로 가진다.
- 이 questions는 conversation을 Memory로 inject하고 그 memory를 기반으로 답하도록 하는 memory system 평가에 적합한 질문들이다.
- question은 multiple categories로 분류될 수 있는데 아래와 같다.
- single-hop : 하나의 정보원이나, 단일 추론으로 답할 수 있는 질문
- multi-hop : 여러 정보를 연결하거나 다단계 추론이 필요한 질문
- temporal : 시간 정보나 시간적 순서가 중요한 질문
- open-domain : 특정 분야에 국한되지 않은 광범위한 주제의 질문
- 또한 adversarial이라는 system이 답할 수 없는 question을 인식할 수 있는지 판단하는 category도 존재한다.
- 근데 이 방법은 초기 방법론과 공정한 비교를 위해 제거했다고 한다.
- 초기 방법론 논문을 안 봐서 잘 모르겠찌만 해당 논문에서는 이를 테스트하지 않았거나 구조상 불가하기 때문으로 보인다.
4.1.2. Evaluation Metrics and Implementation Details
- 이 논문의 평가 방식에 대해 설명한다. 간단하게 이 논문에서는 GPT-4.1을 활용한 LLM-as-a-Judge을 주요 평가 방식으로 이용한다.
- 평가 요소는 question, answer, response 이며 이를 바탕으로 response가 question을 성공적으로 설명하는지 판단한다.
Implementation Details for ScreenshotVQA
- 모든 실험에서 gemini-2.5-flash-preview-04-17 model을 backbone으로 사용한다.
- 이는 위에서 언급하였듯이 Google Cloud와 seamlessly 통합되어 asynchronous image upload/retrieval이 가능하기 때문이다.
- 이를 통해 processing을 상당하게 가속했다고 한다.
Implementation Details for LOCOMO
- MIRIX는, 모든 agent가 memory system에 정보를 넣기 위해 많은 function calling을 요구하기 때문에, function calling을 잘하는 모델이 요구된다.
- 결국 gpt-4.1-mini 를 backbone으로 사용했다고 한다. (Berkeley Function Calling Benchmark에서 좋은 성적을 거둠 gpt-4o-mini대비 약 30% 향상된 성적)
- Mem0의 코드를 이용하여 LangMem,RAG-500,Mem Baseline으로 실행하였고, Zep은 직접 제공한 공식 repository 코드를 이용하여 측정했다고 한다.
- Model은 통일을 위해 모두 gpt-4.1-mini로 교체했다고 한다.
- 모든 baseline에 대해서는 code를 1번씩 실행하였고, MIRIX와 Full Context 방법에 대해서는 평균 점수를 report하기 위해 3번 실행하였다고 한다. (각 시행의 결과도 부록에 있어 아래 결과에 2개를 첨부한다.)
4.2. Experimental Result on ScreenshotVQA
4.3. Experimental Result on LOCOMO

마무리
이렇게 현재 기준 SOTA인 Memory System MIRIX에 대해 알아보았다.
보면 볼수록 크게 어려운 아이디어는 아니라고 생각이 드는데, 높은 성능을 내는 것이 신기하다.
이를 제대로 이해하기 위해 아래 과정을 진행하고 포스팅하고자 한다.
- MIRIX Code 분석
- Mem0,Zep,LangMem,RAG-500 논문 읽기
- 나만의 Memory System 구현하기 <- 이건 가능할지 잘 모르겠다. 열심히 해봐야지
'Article, Paper' 카테고리의 다른 글
| [ Activation Function ] GEGLU (Unlocking the Power of GeGLU) (0) | 2025.09.03 |
|---|---|
| [ RAG ] From Local to Global: A GraphRAG Approach to Query-Focused Summarization (0) | 2025.08.26 |
| Agentic AI v.s. AI Agent (0) | 2025.08.17 |
| [ Agent ] RAG Technique 정리 (0) | 2025.08.10 |
| SmolLM3 Article 정리 (0) | 2025.08.07 |