본 글은 pinecone에서 정리한 Advanced RAG Technique에 나온 RAG Architecture를 정리한 글입니다.
Advanced RAG Techniques | Pinecone
We explore several advanced RAG techniques and demonstrate an implementation that draws on the lessons learned from each.
www.pinecone.io
들어가며
교내에서 많은 Agent 프로젝트를 진행해보았지만, 제대로 Agent Architecture에 대한 공부를 진행해본 적은 없다.
단순하게 인터넷에서 접한 아키텍처와 내가 생각했을 때, 효율적일 것 같은 방식들을 조합하여 제작해보기만 했는데, 이렇게 하다보니 내 구현 방식의 확장에 한계를 느끼고, 계속해서 어떠한 구현 범위 내에 머무른다는 생각이 들었다.
이를 극복하고자 Agent Architecture에 대한 공부를 지속적으로 진행해보고자 한다.
이는 그 첫번째 글로 RAG Technique에 관한 pinecone의 정리글이다.
Introduction
- RAG는 LLM을 다루는 application에서 dominant pattern이 되었다.
- 이는 LLM application이 correct라고 보이는 content로 응답하도록 한다는 사실때문이다.
- 간단하게 말해 올바른 것을 기반으로 응답하도록 해야 하는데 여기에 좋은 것이 RAG기 때문이라는 말이다.
- 이는 LLM application이 correct라고 보이는 content로 응답하도록 한다는 사실때문이다.
- 여기서 Correct라는 것은 무엇일까?
- Correctness는 application의 의도와 user의 의도에 모두 의존하는 주관적인 지표다.
- RAG는 이러한 두 가지 의도 모두에 맞게 응답하도록 한다.
- 하지만, 이러한 RAG에도 문제가 존재한다. naive implementation은 거의 production grade requirements를 만족하지 못한다.
- 그 이유는 아래와 같다.
- Question ambiguity : User가 명확하지 않은 질문을 종종한다. 이때, 명확하지 않은 질문은 잘못된 retrieval를 야기한다. (이는 예전에 다룬 RAG글에서도 문제로 다룬 적이 있다.)
- Low retrieval accuracy : Retrieved document가 모두 question과 관련 있는 것은 아니기 때문이다.
- Limited knowledge : knowledge base가 user가 찾고 있는 정보를 포함하지 않을 수 있다.
- Context window performance limitations : over-retrieve를 시도하는 것은 context window의 용량에 영향을 줄 수 있고, 그게 아니라면 결과를 reasonable한 시간 내에 반환하기에는 너무 큰 context window를 생성할 수 있다.
- 위와 같은 한계를 해결하기 위해 new advanced RAG pattern이 나오고 있다.
- 본 글에서는 그 중 3가지 유명한 pattern을 다룰 것이고, 3가지로부터 배운 것을 기반으로 example을 구현한다.
- There is no silver bullet -> 하나의 방법으로 모든 것을 해결할 수 있는 그런건 없다.
- 여기에서 말하는 각 방법론은 특정 상황에선 poor result를 만들 수도 있다. 이 글의 목적은 RAG application 실행에서 흔하게 발생하는 문제들을 해결하기 위한 몇가지 Technique을 조사하는 것이다.
- 그 이유는 아래와 같다.
Self Reflective RAG
- 해당 Architecture는 SELF-RAG paper에 소개된 내용이다.
- 해당 논문은 adaptive information retrieval과 self critique에 대한 mechanism을 통합하는 finetuned model을 설명한다.
- 즉, model은 외부정보가 필요할 때를 동적으로 결정하고, 생성된 응답의 연관성과 factual accuracy를 평가한다.
- 이 finetuning process의 핵심은 reflection and critique token과 같은 새로운 element에 있다.
- Relection token은 model이 additional information을 검색할지에 대한 informed decision을 내릴 수 있게 한다.
- 이때 action은 오직 repsonse에 가치를 추가할 때만 취하도록 보장한다.
- 간단하게 말해, Reflection token은 model이 검색을 할 지 말지 정보에 기반한 결정을 내릴 수 있게 해주고, 이때 검색은 response가 더 나아질 때만 취하도록 하는 것이다.
- 이때 action은 오직 repsonse에 가치를 추가할 때만 취하도록 보장한다.
- Critique token은 model이 응답의 품질과 retrieved information을 평가하도록 하고, 이를 통해 accuracy와 relevance의 높은 수준을 promoting한다.
- 간단하게 말해서 Critique token은 평가하도록 해서 정확하고 관련있는 결과를 생성하도록 촉진한다는 것
- SELF-RAG 훈련 과정은 prompt와 response로 이루어진 usual dataset으로 시작하고, reflection과 critique token을 추가한다.
- 이 Dataset으로 model이 언제 어떻게 generation의 관련성, factual alignment를 평가해야하는지 이해할 수 있게 훈련한다.
- main model은 end-to-end training을 통해 adaptive retrieval and internal critique의 기능을 operation에 통합하는 방법을 학습한다.
- Relection token은 model이 additional information을 검색할지에 대한 informed decision을 내릴 수 있게 한다.
- 간단하게 종합하면, SELF-RAG에서는 Finetuning된 LLM이 reflection token과 critique token을 이용하여 RAG를 더 잘 할 수 있게 해주는 방법이라고 생각하면 될 것 같다.
- 단순하게 그냥 RAG를 하네 마네가 아닌 model 자체에 special token을 추가하여 RAG를 효율적으로 할 수 있게 한다는 것이 좋은 아이디어인 것 같다. 이러한 시도는 크게 어렵지 않을 것 같아서 나중에 실습으로 한 번 해보려 한다.
- 해당 논문은 adaptive information retrieval과 self critique에 대한 mechanism을 통합하는 finetuned model을 설명한다.
SELF-RAG Architecture
- 동작 과정은 아래와 같다.
- Input 입력
- Input을 기반으로 Reflection Token 생성
- Retrieve 필요 여부 판단
- 필요 하다면
- Document Retrieve 진행
- Retrieve Docs와 함께 응답 생성
- 응답을 평가하기 위한 Critique Token 생성
- Critique 결과가 좋은가?
- 좋다면 Return
- 별로라면 Revise하고 다시 생성
- Critique 결과가 좋은가?
- 필요하지 않다면
- 즉시 Language model로 응답 생성
- 필요 하다면

Corrective RAG
- 이는 Corrective RAG(CRAG) paper에 소개된 intelligently re-incorporating information으로 language model의 정확도를 향상시키는 방법론이다.
- CRAG은 아래와 같은 방법이다.
- query로 획득한 document의 품질을 평가하기 위한 evaluator를 사용
- evaluator는 Document들을 평가하여 정보를 사용할지 무시할지 추가 정보를 요청할지 결정
- CRAG는 web search를 사용하여 static database를 넘어서 더 넓고 최신 정보에 접근을 보장받아 step을 나아간다.
- 간단하게 말해, 그냥 내가 갖고 있는 data만 이용하는게 아니라 web search를 이용해서 database에 없는 정보로도 응답한다는 것이다.
- 또한 web search 외에도, retrieved documents를 break down하고, rebuild하는 unique strategy를 사용하여 방해 요소를 제거하면서 더 관련있는 정보를 얻는 것에 집중한다.
- external knowledge의 사용을 더 잘 제어하는 것은 아래와 같은 장점이 있다.
- CRAG은 생성 품질을 크게 향상시킬 수 있음
- 기존 RAG 기반 모델과도 쉽게 결합할 수 있어서 많은 변경 없이도 effectiveness를 올릴 수 있음
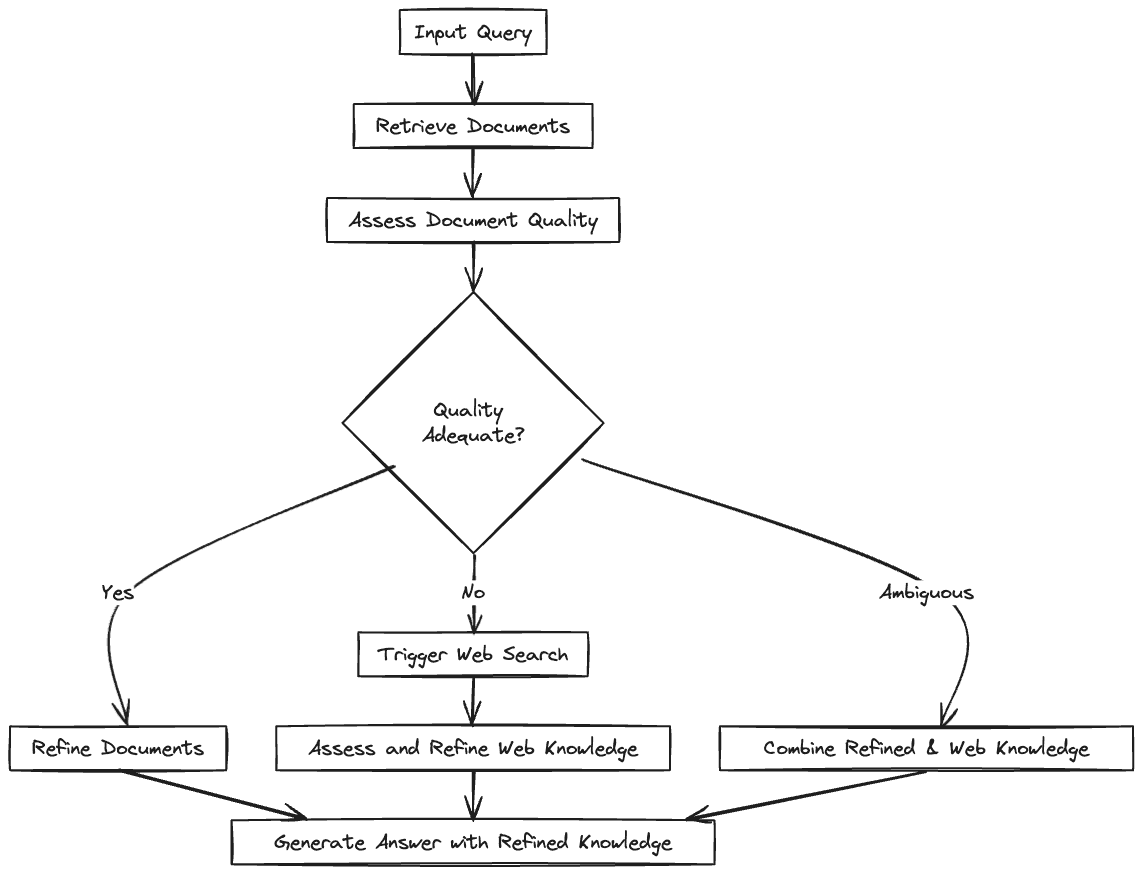
CRAG Architecture
- 동작 과정은 아래와 같다.
- Input 들어옴
- Retrieve 진행
- Document의 quality 평가
- 적절함
- Document Refine하여 Generate Answer
- 부적절함
- Web Search 시작
- Web knowledge 평가 및 refine
- Refine된 결과로 Generate Answer
- 애매함
- web 지식과 document를 모두 이용하여 결과 생성
- 적절함
RAG Fusion
- RAG Fusion은 multiple derivative queries를 생성하며 시작한다.
- user input의 이해를 넓히는 과정
- 다양한 관점에서 탐색하는 것
- 그리고, vector search(RAG)로 origianl 과 derivative queries로부터 관련 document identify한다.
- 이렇게하면 다양한 범위의 관련된 정보가 나옴
- Document Retrieval 후에, RRF(Reciprocal Rank Fusion) algorithm은 their relevance를 기반으로 document를 rerank함,
- 이러한 document들은 결합되어 comprehensive and relevant information source 형태가 된다.
- 마지막 단계에서 이러한 결합된 dataset과 모든 query들은 LLM에 의해 처리되어 well-articulated and contextually relevant response를 생성한다.
이 systematic approach를 통해, RAG-Fusion은 accuracy랑 response의 comprehensiveness를 향상시키고, 상당하게 answer quality를 향상시킨다.
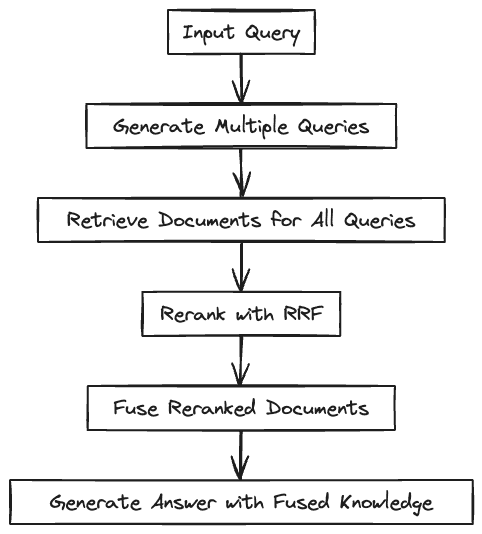
RAG Fusion Architecture
- 동작 방식은 아래와 같다.
- Input 받음
- Input으로 Multiple Quries 생성 (질의 확장과 같은 개념으로 봐도 무방해보임)
- 모든 Queries(Generated + Original)로 Document Retrieve
- RRF로 Rerank
- Reranked Document들을 결합
- 결합된 정보로 Answer Generate
종합 정리
| Feature | Self RAG | Corrective RAG | RAG Fusion |
| Overview | retrieval and self-reflection을 통해 LM의 quality와 factuality를 향상시키는 방법 generation에 critique와 adaptive retrieval을 위한 special token을 사용함 |
lightweight retrieval evaluator와 document refinement를 위한 decompose-recompose algorithm으로 generation의 robustness를 향상시킴 augmentation을 위한 large-scale web search를 활용함 |
RAG와 Reciprocal Rank Fusion(RRF)를 결함하여 reciprocal score로 reranking한다. 그리고 documents와 score를 결합하여 더 정확하고 포괄적인 답변을 생성하도록 함 |
| Key Mechanism | retrieval과 generation quality assessment를 위해 reflection token과 critique token으로 finetune | retrieval evaluator를 사용하여 document quality를 평가하고 action(Correct,Incorrect,Ambiguous)을 trigger한다. | original query로부터 다양한 queries를 생성함 RRF를 사용하여 documents를 rerank final output을 위해 위 정보를 fusion |
| Advantages | 응답의 사실성과 다양성을 높임. 다양한 task requirements에 적용가능 |
RAG기반 접근의 성능을 상당히 높임 (short and long form generation task 모두에서) |
더 정확하고 포괄적인 응답 제공 |
예제
- 해당 Article에서는 구현 예시를 보여준다.
- 이 구현 예시는 뭔가 하나의 기술을 구체적으로 구현하는 것이 아니라, 보여준 패턴을 결합하여 구현해보는 것이다.
- Canopy라는 pinecone의 RAG Framework를 사용한 예시를 제공해주었고, 이또한 공부해봐야 할 것 같다.
- 아무튼 Canopy를 사용하여 embedding과 querying process를 구동하고 추가적인 process를 붙여볼 것이다.
- 즉 아래의 과정을 진행한다.
- Query Expansion(질의 확장) : user가 제공한 query를 기반으로 추가적인 query를 생성할 것이다. (가능한 많은 관련된 document의 기회를 향상시키기 위함)
- Critique(평가) : 검색한 content의 평가를 생성하기 위한 LLM을 사용한 function을 만들어볼 것이다.
- External Search(외부 검색) : serach tool을 만들어서 retrieve 결과가 평가 기준을 넘지 못할 때 사용할 수 있게 할 것이다.
- Reranking(리랭크) : Cohere Reranker를 사용하여 retrieved documents의 순서를 최적화할 것이다.
- 이걸 기본 RAG와 비교하며 마무리한다.
- 즉 아래의 과정을 진행한다.
- 어우 근데 이거는 지금 코드를 봤는데 pinecone을 알지 못하면 사용하기 힘든 방식인 것 같다.
- pinecone에 대해서도 학습을 따로 해보아야 할 것 같고, 구현 자체는 기존에 알던 langgraph로 article의 실습 코드와 동일하게 한 번 해보려한다.
- 따라서 이 실습 코드는 조만간(1주일 이내)에 langgraph로 구현해서 포스팅을 진행하고 여기에 링크를 달겠다!
마무리하며
- 내가 생각했던 것보다 특별한 이론은 없었다.
- 하지만 Finetuning을 통한 special token으로 RAG 품질을 향상시키는 아이디어는 내가 전혀 생각해보지 못했던 방법이었다. RAG는 단순하게 언어 모델 자체가 아닌 어떠한 기술과 같은 부분이라고 생각했기 때문인 것 같다.
- 위에서 나온 개념들을 한 번 다시 공부해보고, LLM과 관련된 수많은 지식(진짜 수많음 셀 수 없음 그냥)을 하나씩 공부해봐야겠다.
- 이번에 10월까지 논문 대회가 있는데 이러한 Agent Architecture와 같은 논문을 한 번 내보는 것이 목표다. 오늘과 같은 Article이나 더 많은 논문을 탐색해보고 꼭 논문을 낼 수 있으면 좋겠다 ㅜ(상도 주세요 돈 없어요)
- 끝
'Article, Paper' 카테고리의 다른 글
| [ Activation Function ] GEGLU (Unlocking the Power of GeGLU) (0) | 2025.09.03 |
|---|---|
| [ RAG ] From Local to Global: A GraphRAG Approach to Query-Focused Summarization (0) | 2025.08.26 |
| Agentic AI v.s. AI Agent (0) | 2025.08.17 |
| [ Memory ] MIRIX : Multi-Agent Memory System for LLM-Based Agents (0) | 2025.08.09 |
| SmolLM3 Article 정리 (0) | 2025.08.07 |